مدیریت متمرکز لاگ: جمعآوری، نگهداری، هزینه
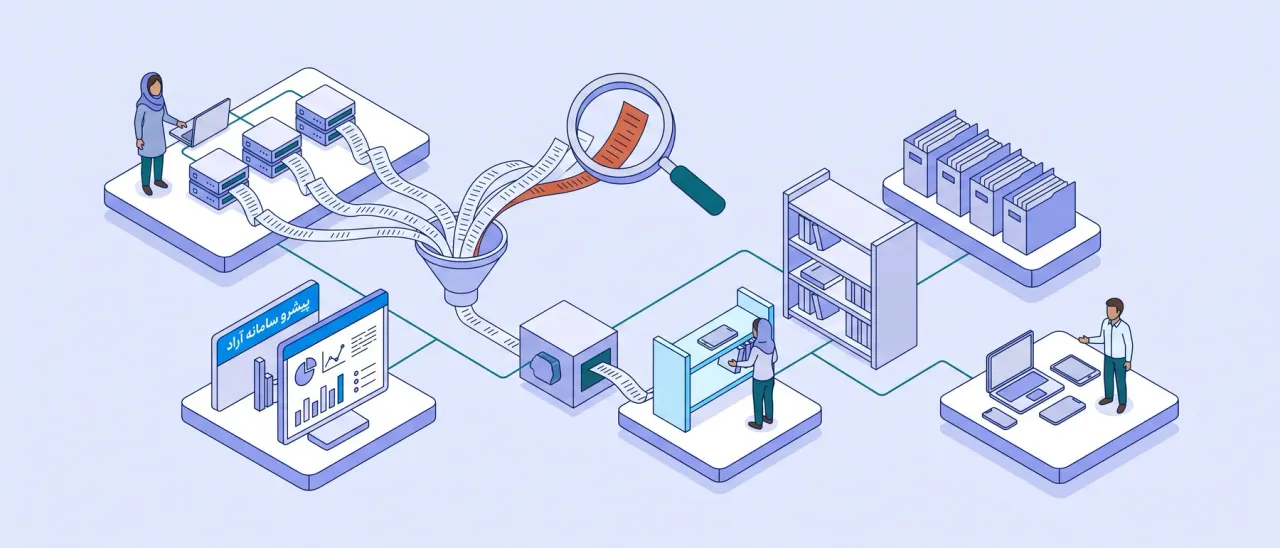
در پایش و لاگ در محیط تولید نوشتهایم که یک خط لاگ مفید چه شکلی است. این مقاله دربارهٔ چیزی است که بعد از آن اتفاق میافتد: وقتی آن خط، ضرب در چهل سرویس و سیصد روز شد.
آن نقطه جایی است که لاگ از یک عادت مهندسی خوب تبدیل میشود به یک سامانه که معماری و بودجه لازم دارد. و تقریباً همیشه غافلگیرکننده است.
چرا grep روی سرور جواب نمیدهد
اگر یک سرور دارید، ورود به آن و جستوجو در فایل کاملاً منطقی است. دلیلی برای پیچیده کردنش نیست.
از جایی به بعد این میشکند، و معمولاً اینطور:
یک درخواست از سه سرویس رد شده و هر کدام روی ماشین دیگری لاگ نوشته. برای دیدن کل ماجرا باید سه بار وارد شوید و بر اساس زمان کنار هم بچینید — و ساعت ماشینها دقیقاً یکی نیست.
یا: ماشینی که لاگش را میخواستید، دیروز مقیاسکم شده و دیگر وجود ندارد. با لاگش.
یا: میخواهید بدانید این خطا در یک ماه گذشته چند بار رخ داده. با grep این
سؤال جواب ندارد.
چهار تکهٔ خط لوله
جمعآوری. یک عامل کوچک روی هر ماشین، یا فرستادن مستقیم از خود برنامه. قاعدهٔ عملی: برنامه باید به خروجی استاندارد بنویسد و جای دیگری مسئول رساندنش باشد. برنامهای که خودش مستقیماً به سرور لاگ وصل میشود، وقتی آن سرور پایین باشد، خودش هم کند یا متوقف میشود. این اتفاق افتاده است.
پردازش. جایی که خط متن به فیلد تبدیل میشود، فیلدهای مشترک اضافه میشوند و دادههای حساس حذف. اگر OpenTelemetry دارید، Collector همینجا مینشیند.
ذخیره و ایندکس. گرانترین تکه. ایندکس کردن چیزی است که جستوجو را سریع میکند و همان چیزی است که هزینه را بالا میبرد.
جستوجو. واسطی که آدمِ ساعت دو بامداد باید بتواند در آن کار کند.
ساختاریافته بنویسید — این تصمیم ارزانترین بخش ماجراست
[2026-11-06 14:22:07] Order 4471 failed for user 1203در برابر:
{"ts":"2026-11-06T14:22:07Z","level":"error","event":"order_failed",
 "order_id":4471,"user_id":1203,"trace_id":"a3f9…","service":"checkout"}
اولی برای آدم خواناتر است و برای ماشین تقریباً بیفایده. با دومی میشود پرسید «همهٔ سفارشهای ناموفق این هفته، گروهبندیشده بر اساس سرویس» — با اولی نمیشود.
یک فیلد از همهٔ اینها مهمتر است: trace_id. همان شناسهای که در
ردیابی توزیعشده تولید میشود. با آن، از یک خط لاگ
به کل مسیر آن درخواست میرسید. بدون آن، همان چیدن دستیِ بر اساس زمان است، فقط
در یک واسط قشنگتر.
هزینه، و اینکه چطور بیصدا بزرگ میشود
الگویی که بارها دیدهایم: پشتهٔ لاگ راه میافتد، عالی کار میکند، همه راضیاند. هجده ماه بعد کسی متوجه میشود ذخیرهسازی لاگ از خودِ سرورهای برنامه گرانتر شده.
هیچکس تصمیم بدی نگرفته بود. فقط سرویسها اضافه شدند، هر کدام کمی پرحرفتر از قبلی، و هیچکس هیچوقت چیزی را حذف نکرد.
دو کار جلویش را میگیرد، و هر دو باید از روز اول باشند چون بعداً اعمال کردنشان سخت است:
سطحبندی نگهداری. همهٔ لاگها یک عمر ندارند:
| نوع | پیشنهاد |
|---|---|
| خطا و هشدار | ۹۰ روز، ایندکس کامل |
| درخواستهای موفق | ۷ تا ۱۴ روز |
| اشکالزدایی مفصل | ۲۴ تا ۴۸ ساعت، و در تولید معمولاً خاموش |
| لاگ حسابرسی و دسترسی | طبق الزام قانونی — جدا نگه دارید |
آن ردیف آخر را جدی بگیرید: لاگ حسابرسی را با لاگ عملیاتی قاطی نکنید. یکی بایگانی ارزان میخواهد و عمر طولانی، آن یکی جستوجوی سریع و عمر کوتاه. یک سطل برای هر دو، یعنی پرداخت گرانترین قیمت برای همهچیز.
نمونهگیری برای چیزهای پرتکرار. اگر یک نقطهٔ پایانی روزی ده میلیون بار صدا زده میشود، لاگ کردن همهاش چیزی به شما نمیگوید که یکدرصدش نگوید. ولی خطاها هیچوقت نمونهگیری نمیشوند — همهشان را نگه دارید.
دادهٔ حساس: قاعدهاش برعکس چیزی است که فکر میکنید
پاک کردن داده از لاگ پس از نوشتنش تقریباً همیشه شکست میخورد. چون باید همهٔ جاهایی را که ممکن است چیزی بنویسند بشناسید، و نمیشناسید.
کار درست این است که در لایهٔ پردازش، فهرست سفید داشته باشید نه سیاه: فقط فیلدهایی که صریحاً مجاز شدهاند عبور کنند، بقیه حذف. بعد یک نفر یک ساعت وقت بگذارد و لاگ واقعی تولید را بخواند.
چیزهایی که مرتب پیدا میشوند: بدنهٔ کامل درخواست ثبتنام همراه رمز، سرآیند
Authorization در لاگ خطای شبکه، شمارهٔ کارت در پیام خطای درگاه، و شمارهٔ ملی
تقریباً همهجا.
برای دادهٔ سلامت الزام سختگیرانهتر است و در امنیت دادهٔ بیمار نوشتهایم. برای کلیدها و توکنها، ریشهٔ مسئله جای دیگری است: مدیریت اسرار.
گزینهها
برای سنجه، Prometheus انتخاب روشن و متنباز است. برای لاگ ماجرا شلوغتر است و ما در پشتههای سنجه و لاگ، کنار هم کنار هم گذاشتهایمشان؛ اینجا فقط دو نکتهٔ تصمیمی:
اگر جستوجوی متن آزاد روی حجم زیاد میخواهید، هزینهتان ایندکس است و باید آگاهانه بپذیریدش. اگر بیشتر وقتها با شناسه و برچسب جستوجو میکنید — که کار اکثر تیمهاست — سامانهای که فقط برچسبها را ایندکس میکند بخش بزرگی از هزینه را میبرد و تفاوتش را حس نمیکنید.
و برای خطاهای برنامه، Sentry کار متفاوتی میکند: دستهبندی و شمارش. این را از انبار لاگ انتظار نداشته باشید؛ دو ابزار برای دو سؤالاند.
نشانهٔ اینکه کار میکند
یک آزمون ساده. بعدی که خطایی رخ داد، کرنومتر بگذارید: از لحظهٔ اطلاع تا لحظهٔ دیدن خط لاگ مربوط، چقدر طول کشید؟
زیر دو دقیقه، خط لولهتان کار میکند. بالای بیست دقیقه، یک انبار لاگ دارید نه یک ابزار عیبیابی — و تفاوتشان همان چیزی است که وسط یک قطعی اهمیت پیدا میکند.